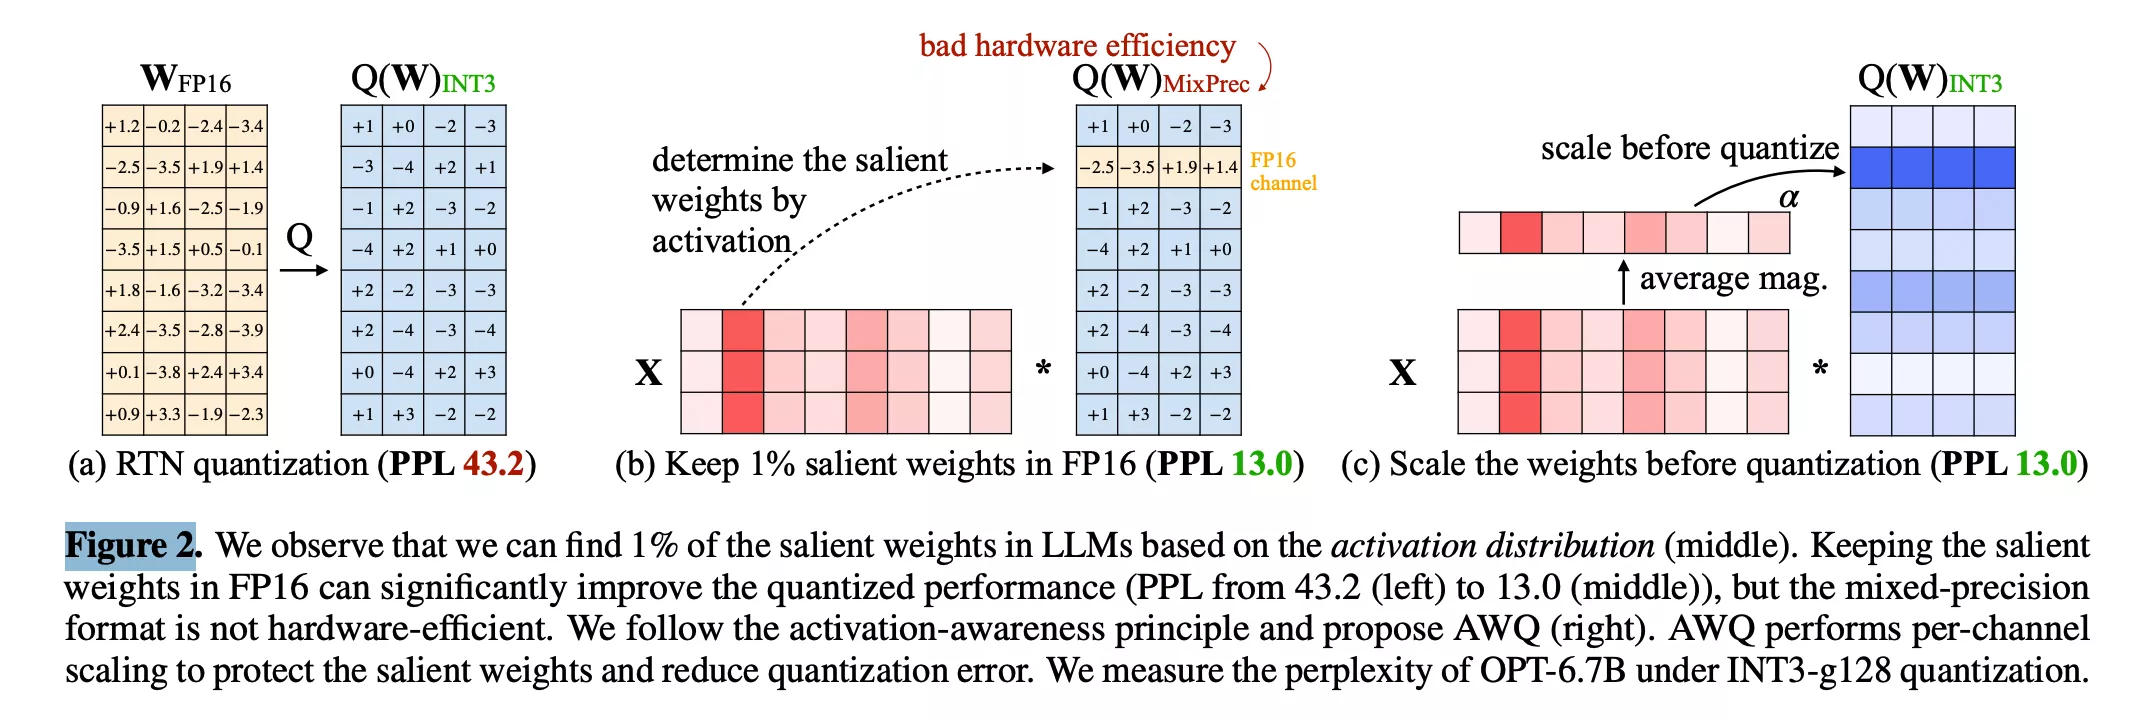
AWQ 的研究团队发现了一个非常有意思的现象:对于 LLM 的权重量化,只有 0.1%-1% 的权重(Salient Weights)决定了最终的精度。
也就是在量化时,把1%的重要权重保留成bf16,其余是INT8,量化后的精度非常好
但是这里引入两个问题:
- 要怎么确定哪些是这1%重要的权重
- 硬件对这种W8/BF16混合精度计算很难高效实现
AWQ的解决思路:“不改变权重的存储格式,而是通过数学等价变换来保护显著权重。”
相比于直接保留 FP16,如果我们把显著权重在量化前按比例放大,它们在量化网格中的相对误差就会减小。同时,为了保证等价性,我们在计算时将对应的激活值按同等比例缩小。
这一块对激活值和权重的操作和SmoothQuant很像,只是SmoothQuant是想把激活值更平滑,AWQ是保护重要权重
核心算法与公式推导
权重的重要性在于:它不看权重本身的大小,而是看输入激活值的大小,因此每个权重通道的缩放系数直接和激活值大小相关
我们的目标是寻找一个最优的逐通道缩放因子 。
等价缩放变换
根据矩阵乘法的结合律,我们在权重 和激活值 之间插入一个对角缩放矩阵 和它的逆矩阵 :
(1)
此时,新的被量化权重变成了 ,新的激活值变成了 。
应用量化后,实际的计算变为:
(2)
误差的最小化
放大显著通道的权重(即 )会增大该组内的最大值 ,从而可能导致量化步长 变大,使得非显著权重的误差增加。因此,AWQ 需要找到一个平衡点,最小化整体的输出误差:
(3)
为了避免在庞大的空间中进行高昂的梯度下降搜索,AWQ 采用了一种启发式的快速搜索策略。
缩放因子 。对于第 个通道,它的基础放大系数取决于该通道在校准集上激活值的平均绝对幅度。
计算公式如下:
(4)
- :校准集中第 个样本在第 个通道的激活绝对值。
- :是一个超参数(通常在 之间搜索)。
- 当 时,相当于不缩放(RTN)。
- 当 时,完全按照激活值的幅度进行缩放。
通过在一小批校准数据(如 128 个样本)上遍历几个 值,AWQ 可以在极短的时间内找到最优的 。
为什么要遍历 ,因为如果为0,就是没变,如果太大,该组的最大值就会暴涨,就会把量化步长拉大,组内其他大量普通的、非重要的权重瞬间丢失所有精度(全部被量化成 0)。
工程实践
这一块和SmoothQuant差不多,都是融合算子,理解了SmoothQuant就知道这个了,区别是SmoothQuant是W8A8,而AWQ一般是会W4A16